Domain radiostatus.de kaufen?
Wir ziehen mit dem Projekt
radiostatus.de um.
Sind Sie am Kauf der Domain
radiostatus.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain radiostatus.de kaufen?
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **

Ähnliche Suchbegriffe für Textklassifizierung
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
Martin, Piekar: Livestream & LeichenLivestream & Leichen , Was als Spaziergang beginnt, entpuppt sich bald als Tour de Force, als Streitgespräch mit Bots, Bekannten, Liebhaber*innen - vor allem Leichen. Wie ein Chor aus griechischen Tragödien fordern die Toten genauso wie der lebendige digitale Livestream immer wieder das Gespräch und mit der Vergangenheit und mit der Gegenwart. In digitalen Räumen, unter Bettdecken und in Krankenhäusern: Überall fragen die Leichen, wie die Zukunft zu gestalten ist, wenn wir uns gemeinschaftlich der Realität versperren. Piekars Schreiben ist eine Einladung, mit ihm zu gehen, zu schreiten, zu rennen und innezuhalten: auf Parkbänken, unter Brücken und Verkehrsinseln. , Automatische Niveauregulierung > Federung & Lenkung , Erscheinungsjahr: 20230601, Produktform: Kartoniert, Titel der Reihe: Edition Belletristik##, Autoren: Martin, Piekar, Illustrator: Kaun, Nina, Seitenzahl/Blattzahl: 160, Keyword: Digital; Gedichte; German Angst; Leichen; Lyrik; Spaziergang, Fachkategorie: Belletristik und verwandte Gebiete, Thema: Auseinandersetzen, Warengruppe: HC/Belletristik/Lyrik/Dramatik/Essays, Fachkategorie: Lyrik, Poesie, Thema: Entspannen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Verlagshaus Berlin, Verlag: Verlagshaus Berlin, Verlag: Verlagshaus Berlin, Länge: 187, Breite: 125, Höhe: 10, Gewicht: 194, Produktform: Kartoniert, Genre: Belletristik, Genre: Belletristik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0014, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
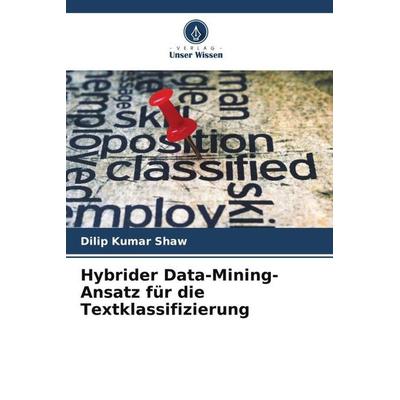
Hybrider Data-Mining-Ansatz für die Textklassifizierung, Taschenbuch von Dilip Kumar Shaw, Verlag Unser Wissen, 978-620-5-46330-7Hybrider Data-mining-ansatz Für Die Textklassifizierung, Taschenbuch Von Dilip Kumar Shaw, Verlag Unser Wissen, 978-620-5-46330-7, Seitenanzahl: 6835,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Neuartige Technik zur Textklassifizierung, Taschenbuch von Abhishek Bhardwaj,Amarpreet Singh,Virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3Neuartige Technik Zur Textklassifizierung, Taschenbuch Von Abhishek Bhardwaj,amarpreet Singh,virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3, Seitenanzahl: 6843,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Martin, Piekar: Livestream & LeichenLivestream & Leichen , Was als Spaziergang beginnt, entpuppt sich bald als Tour de Force, als Streitgespräch mit Bots, Bekannten, Liebhaber*innen - vor allem Leichen. Wie ein Chor aus griechischen Tragödien fordern die Toten genauso wie der lebendige digitale Livestream immer wieder das Gespräch und mit der Vergangenheit und mit der Gegenwart. In digitalen Räumen, unter Bettdecken und in Krankenhäusern: Überall fragen die Leichen, wie die Zukunft zu gestalten ist, wenn wir uns gemeinschaftlich der Realität versperren. Piekars Schreiben ist eine Einladung, mit ihm zu gehen, zu schreiten, zu rennen und innezuhalten: auf Parkbänken, unter Brücken und Verkehrsinseln. , Automatische Niveauregulierung > Federung & Lenkung , Erscheinungsjahr: 20230601, Produktform: Kartoniert, Titel der Reihe: Edition Belletristik##, Autoren: Martin, Piekar, Illustrator: Kaun, Nina, Seitenzahl/Blattzahl: 160, Keyword: Digital; Gedichte; German Angst; Leichen; Lyrik; Spaziergang, Fachkategorie: Belletristik und verwandte Gebiete, Thema: Auseinandersetzen, Warengruppe: HC/Belletristik/Lyrik/Dramatik/Essays, Fachkategorie: Lyrik, Poesie, Thema: Entspannen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Verlagshaus Berlin, Verlag: Verlagshaus Berlin, Verlag: Verlagshaus Berlin, Länge: 187, Breite: 125, Höhe: 10, Gewicht: 194, Produktform: Kartoniert, Genre: Belletristik, Genre: Belletristik, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0014, Tendenz: +1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
-
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **
-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
Ähnliche Suchbegriffe für Textklassifizierung
-
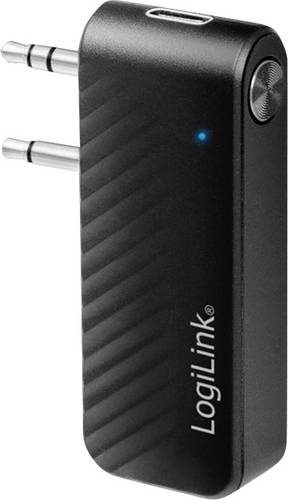
LogiLink BT0061 Bluetooth Musik-Sender Bluetooth Version: 5.1 7mDieser Audio-Transmitter ist die perfekte Lösung, um das Unterhaltungssystem im Flugzeug mit BT zu erweitern. Schließen Sie ihn mühelos an Ihren Flugzeugsitz oder an den 3,5-mm-Anschluss des Bordfernsehers. Verbinden Sie sich schnell mit Ihren BT-Kopfhörern, Ohrstöpseln oder AirPods und genießen Sie Ihr Inflight-Entertainment kabellos. Der eingebaute Akku hat eine Laufzeit von bis zu 10 Stunden und ist somit auch für längere Flüge bestens geeignet.11,05 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
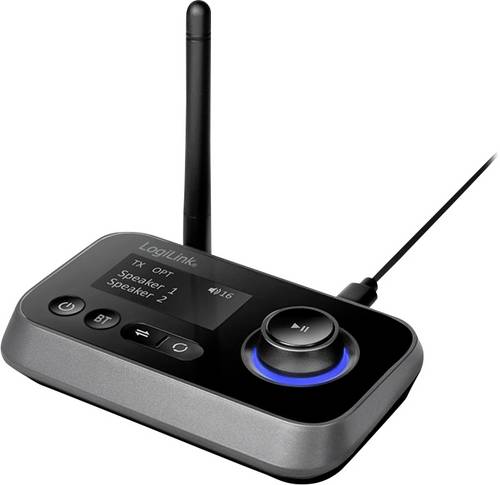
LogiLink BT0062 Bluetooth Musik-Sender/Empfänger Bluetooth Version: 5.0 10mBringen Sie Freiheit und Komfort in Ihr Zuhause. Mit dem BT0062 von LogiLink schaffen Sie eine bequeme Möglichkeit, Ihr Home-Entertainment-System um BT-Streaming-Funktionen zu erweitern oder Musik auf Ihre BT-Kopfhörer und -Lautsprecher zu übertragen. Für ein schnelles Koppeln der Geräte und eine stabile Verbindung sorgt die BT-5.0-Technologie.25,61 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
-
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
-
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.